رباتهای هوش مصنوعی و robots.txt؛ بلاک GPTBot یا اجازه دادن؟
robots.txt دیگر فقط یک فایل فنی نیست؛ تابلوی قوانین ورودِ سایت شماست. رباتهای هوش مصنوعی به دو خانوادهی جدا تقسیم شدهاند: رباتهای آموزش که محتوا را برای تربیت مدل میبرند و در ازایش ترافیک نمیآورند، و رباتهای جستجو و پاسخ که محتوای شما را در پاسخها استناد میدهند. با یک خط قاعده میتوانید اولی را ببندید و دومی را باز بگذارید؛ این تصمیم امروز به عرف غالب سایتهای بزرگ تبدیل شده است. اما یک نکتهی مهم: بلاککردن در برخی لایهها بیاثر است و مکانیزم واقعی محدودکردن قابهای گوگل، جای دیگری است. در این مقاله هر دو طرف را با داده به شما نشان میدهیم.
نکات کلیدی
- بلاک GPTBot فقط مسیر آموزش را میبندد، نه مسیر دیدهشدن در پاسخها؛ اوپنایآی برای جستجوی چتجیپیتی ربات جداگانهای دارد و آن یکی را باید باز بگذارید.
- Google-Extended یک ربات نیست؛ یک کلید تنظیم است که روی آموزش مدلهای گوگل اثر میگذارد و بهتصریح خود گوگل، هیچ اثری بر ایندکس و رتبهی سایت شما ندارد.
- robots.txt ابزار بازدارنده است، نه در قانون؛ بعضی رباتهای کاربرمحور، از جمله مواردی که برای بازکردن یک لینک بهدرخواست کاربر میآیند، ممکن است آن را نادیده بگیرند.
- سیاستی که در robots.txt نوشته میشود ولی لایهی CDN آن را نقض میکند، روی کاغذ میماند؛ در بررسیهای میدانی، سهم قابلتوجهی از سایتها در عمل به رباتی که بسته بودند پاسخ میدهند.
- معیار تصمیمگیری، نسبت خزش به ارجاع است: هر رباتی که در ازای هر هزار بازدید، فقط یک بازدیدکننده برمیگرداند، باید توضیح بدهد چرا باید باز بماند.
چرا حالا سر و صدای robots.txt بالا گرفته است؟
بیش از سه دهه از عمر این فایل میگذرد و تا چند سال پیش، کارش ساده بود: به رباتهای موتور جستجو میگفت بخشهایی مثل سبد خرید یا پنل کاربری را نخوانند. حالا همان فایل، نقش تابلوی قوانین ورود یک ساختمان را بازی میکند؛ تابلوئی که همهی همسایهها میخوانند و از آن نتیجه میگیرند شما چه سیاستی دارید.
دو اتفاق این تغییر را جدی کرد. اول، رشد سرسامآور درخواستهای رباتهای هوش مصنوعی؛ اندازهگیریهای زیرساختی نشان میدهد حجم این درخواستها چند برابر سریعتر از ترافیک انسانها رشد میکند. دوم، تصمیم شرکتهای بزرگ زیرساخت که از اواسط ۱۴۰۵ شروع کردند به بستن پیشفرض بخشی از این رباتها روی سایتهایی که تبلیغ نمایش میدهند.
نتیجه اینکه دیگر نمیتوانید بیتصمیم بمانید. نبودِ سیاست هم یک سیاست است؛ اسمش «باز گذاشتن همهچیز» است.
سه خانوادهی ربات؛ تفکیکی که کل تصمیم را عوض میکند
تصمیم دربارهی رباتها وقتی سردرگم میشود که همه را در یک سبد بریزیم. در عمل با سه خانواده روبهرو هستید، بهعلاوهی یک مهمان تازه.
- رباتهای آموزش: محتوای سایت را جمع میکنند تا در تربیت مدلهای نسل بعد استفاده شود. نمونهاش GPTBot، ClaudeBot و CCBot. ترافیک مستقیمی برنمیگردانند و اثرشان برندسازیِ غیرقابلاندازهگیری است.
- رباتهای جستجو و پاسخ: کارشان ساختن و بهروز نگهداشتن ایندکسی است که پاسخها از آن تغذیه میشوند؛ مثلاً OAI-SearchBot و PerplexityBot. بستنشان یعنی حذف خودتان از دایرهی استناد.
- رباتهای کاربرمحور: وقتی کاربری از دستیار میخواهد صفحهای را باز کند، همان لحظه به سایت شما سر میزنند؛ مثل ChatGPT-User. اینها بازدیدکنندهی واقعی میآورند.
- مرورگرهای عامل: دستیارهایی که مثل مرورگر برای کاربر کار میکنند و در آمار ترافیک ۱۴۰۵ سهم رو به رشدی گرفتهاند. رفتارشان شبیه کاربر است، نه خزنده.
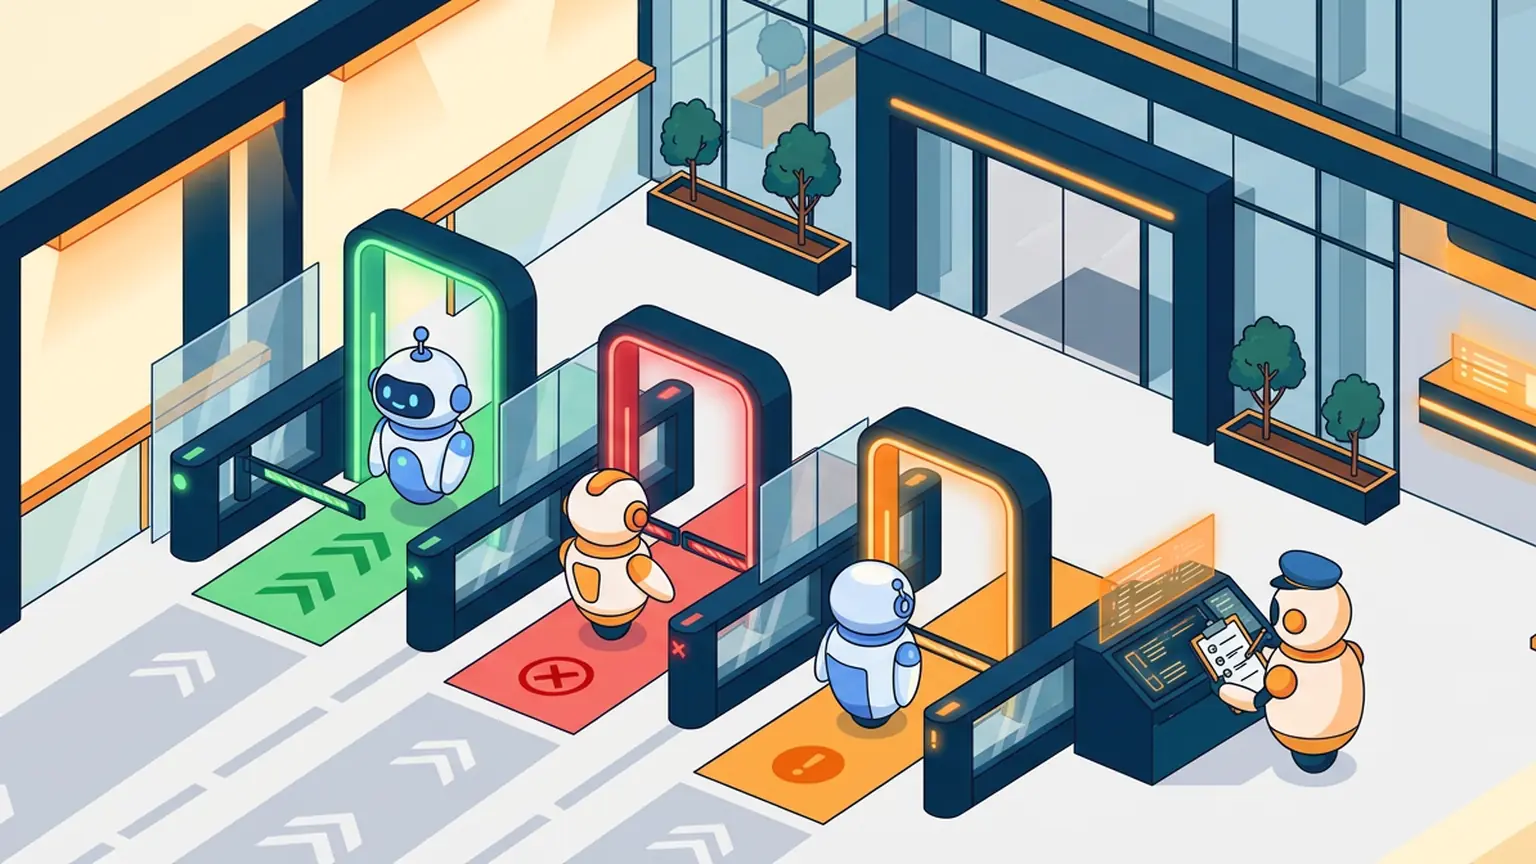
قدم اول هر سیاستی همین است: برای هر خانواده، جدا تصمیم بگیرید. اکثر سایتها به یک ترکیب میرسند: آموزش بسته، جستجو و کاربر باز.
جدول رباتها: کدام کیست و بلاککردنش چه هزینهای دارد؟
| ربات | اپراتور | کارش | بلاککردن یعنی چه؟ |
|---|---|---|---|
| Googlebot | گوگل | ایندکس جستجو، شامل قابهای هوش مصنوعی در جستجو | حذف از جستجوی گوگل؛ هیچوقت این کار را نکنید |
| Google-Extended | گوگل | کنترل استفادهی آموزشی از محتوای خزششده | فقط آموزش مدلهای گوگل؛ بر جستجو اثری ندارد |
| GPTBot | اوپنایآی | آموزش مدلها | توقف استفادهی آموزشی؛ بر دیدهشدن در پاسخها اثری ندارد |
| OAI-SearchBot | اوپنایآی | ایندکس جستجوی چتجیپیتی | خروج از دایرهی استناد در چتجیپیتی |
| ChatGPT-User | اوپنایآی | بازکردن صفحه بهدرخواست کاربر | بستن صفحه به روی خود کاربر |
| ClaudeBot | آنتروپیک | آموزش و بهسازی مدل | توقف آموزش؛ جستجوی کلود کلید جداگانه دارد |
| Claude-SearchBot / Claude-User | آنتروپیک | جستجو و بازکردن صفحه بهدرخواست کاربر | خروج از استناد یا بستن صفحه به روی کاربر |
| PerplexityBot | پرپلکسیتی | ساختن پاسخ و لینکدادن به منابع | خروج از منابع پرپلکسیتی |
| Perplexity-User | پرپلکسیتی | بازکردن صفحه بهدرخواست کاربر | در عمل کنترلپذیر نیست؛ شرکت گفته ممکن است نادیده بگیرد |
| bingbot | مایکروسافت | ایندکس بینگ و تغذیهی دستیارها | حذف از بینگ و کاهش شانس استناد در ابزارهای متصل |
| Applebot / Applebot-Extended | اپل | جستجوی سیستمی / کنترل آموزش | بستن Applebot یعنی حذف از جستجوی سیستمی اپل |
| CCBot | کامنکرال | ساختن مخزن عمومی وب | خروج از مجموعهدادهای که مصرفکنندههایش نامعلوماند |
| Bytespider | بایتدنس | خزش برای محصولات هوش مصنوعی | کاهش بار سرور؛ در بعضی اندازهگیریها این ربات به بلاکها بیاعتناست |
| Meta-ExternalAgent | متا | آموزش و ایندکسکردن محتوا | توقف یک مسیر آموزشی با ارجاع تقریباً صفر |
سه نکته دربارهی این جدول:
- Googlebot تنها سطر «هرگز نباید بست» است. بقیه سطرها، تصمیم تجاریاند، نه تصمیم فنی.
- اسم ربات حساس به بزرگی و کوچکی حرف نیست، اما املای آن باید دقیق باشد؛ یک کاراکتر اشتباه یعنی قاعدهای که هیچکس اجرا نمیکند.
- سیاست فقط برای خودتان نیست. رقیبها هم robots.txt شما را میخوانند و از آن دربارهی مدل کسبوکارتان نتیجه میگیرند.
بلاک GPTBot چه چیزی را عوض میکند و چه چیزی را نه؟
این پرسش، پرتکرارترین سؤال مشتریان ماست و پاسخش دو بخش دارد.
چه چیزی عوض میشود: محتوای شما از مسیر آموزشی این شرکت خارج میشود. اگر موضع شما این است که «کار ما بدون قرارداد، مادهی خام مدل کسی نمیشود»، این خط قاعده همان موضع را اجرا میکند.
چه چیزی عوض نمیشود: دیدهشدن در پاسخهای چتجیپیتی، چون آن مسیر از ربات دیگری تغذیه میشود. همچنین رتبهی شما در گوگل، چون این ربات هیچ نقشی در جستجو ندارد.
یک نکتهی صادقانه هم هست که در تبلیغات کمتر گفته میشود. بخشی از ارزش برند، از حضور نام شما در دادهی آموزشی میآید؛ همان چیزی که باعث میشود مدلها وقتی دربارهی یک حوزه حرف میزنند، نام برندهای آشنا را بشناسند. این اثر قابلاندازهگیری نیست و بسته به پروژه است. پس نه میتوان گفت بستنش حتماً به شما ضرر میزند، نه میتوان گفت بیهزینه است.
- پیشنهاد ما به شما:
گوگل و استثنای مهمش: Google-Extended یک ربات نیست
رایجترین سوءتفاهم این حوزه همین است. خیلی از تیمها فکر میکنند با بستن Google-Extended از قابهای هوش مصنوعی گوگل بیرون میآیند. اینطور نیست.
Google-Extended هیچوقت به سایت شما سر نمیزند؛ خزندهی اصلی همان Googlebot است. این کلید فقط به گوگل میگوید محتوای خزششده اجازهی استفادهی آموزشی و قرینهسازی در محصولات مدلمحور را دارد یا نه. خود گوگل در مستنداتش صریح نوشته که این تنظیم نه بر حضور سایت در جستجو اثر میگذارد و نه سیگنال رتبهبندی است.
پس بستن Google-Extended، حضور شما در نمای هوش مصنوعی جستجو و حالت هوش مصنوعی را دستنخورده میگذارد. حتی بررسیهای میدانی نشان داده بخشی از نتایج خبری که داخل همان پاسخهای خلاصه نمایش داده میشوند، از مسیر robots.txt قابل بستن نیستند.
کنترل واقعی کجاست؟ در تنظیمات پیشنمایش و در سرچ کنسول. گزینههای «بدون قطعهی متن» و خویشاوندانش میتوانند حضور شما را در قابهای هوش مصنوعی جستجو محدود کنند، و سرچ کنسول هم تنظیم جداگانهای برای بیرونماندن از این قابها دارد. اینها ابزارهای کُندی هستند؛ اثرشان به کل جستجو سرایت میکند. اگر تصمیم شما «من در قابهای هوش مصنوعی نباشم» است، باید بدانید بهایش را با بخشیدن بخشی از حضور عمومیتان میپردازید.
تلهی رایج: بلاکی که روی کاغذ میماند
فرض کنید در robots.txt نوشتهاید GPTBot نباید وارد شود. تمام؟ نه. بررسیهای میدانی روی چند هزار دامنه نشان میدهد در بخش قابلتوجهی از سایتها، همان ربات بستهشده همچنان پاسخ میگیرد. در یک نمونه، نزدیک نیمی از سایتها و حدود چهل درصد ناشران در این وضعیت بودند.
چرا؟ چون کنترل دسترسی فقط در یک لایه نمیگذرد:
- لایهی CDN یا فایروال میتواند قاعدهی شما را بیاثر یا تقویت کند. در اندازهگیری سرویسدهندههای مختلف، رفتارها زمین تا آسمان تفاوت دارد؛ یکی تقریباً همه را میبندد، یکی به چالش میکشد و یکی فقط سرعت را کم میکند.
- سیاست پیشفرض اپراتور زیرساخت ممکن است چیزی را ببندد که شما باز میخواستید، یا برعکس.
- بعضی رباتها از ابتدا گفتهاند که به robots.txt پایبند نیستند؛ بهخصوص آنهایی که بهدرخواست کاربر صفحهای را باز میکنند.
درس عملی این بخش یک جمله است: سیاست دسترسی باید در همهی لایهها یکسان باشد، وگرنه بیسیاستی است با ظاهر سیاست.
نسبت خزش به ارجاع؛ عددی که تصمیم را منطقی میکند
معیار سادهای وجود دارد که بحث را از سلیقه بیرون میآورد: در ازای هر بازدیدکنندهای که یک ربات برایتان میآورد، چند بار به سایت شما سر زده است؟
| اپراتور | نسبت خزش به ارجاع (بر پایهی دادهی نیمهی اول ۱۴۰۵) |
|---|---|
| آنتروپیک | حدود ۴٬۵۰۰ به ۱ |
| اوپنایآی | حدود ۸۵۰ به ۱ |
| پرپلکسیتی | حدود ۱۵۰ به ۱ |
| مایکروسافت | حدود ۳۳ به ۱ |
| گوگل | حدود ۵ به ۱ |
خواندن این جدول ساده است. هرچه عدد بزرگتر، یعنی آن ربات بیشتر میگیرد و کمتر پس میدهد.
سه هشدار لازم است:
- این اعداد ثابت نیستند. نسبت آنتروپیک در یک سال بیش از ده برابر بهتر شده و اوپنایآی هم بهبود داشته؛ پس تصمیم را روی عکس امروز نگیرید، روی روند بگیرید.
- نسبت، تنها معیار نیست. بخشی از ارزش پرپلکسیتی، برندسازی است، نه عدد ارجاع.
- بهترین داده، دادهی خودتان است. ماهی یکبار لاگ سرور را باز کنید، درخواست هر ربات را جدا بشمارید و ارجاعهای ورودی از دستیارها را با آن مقایسه کنید. اگر این کار برایتان سنگین است، در مقالهی «سئو تکنیکال: مترجم اختصاصی بین وبسایت و رباتهای گوگل» توضیح دادهایم چطور بررسی فنی سایت را از پایه شروع کنید.
- پیشنهاد ما به شما:
یک نمونهی ایرانی: نُه ماه بستهبودن و هزینهی باز شدن
وضعیت شروع: یک سایت آموزشی با چند هزار مقاله. تیم محتوا خبردار میشود متنهایشان در پاسخهای هوش مصنوعی دیده میشود و مدیرعامل دستور میدهد «همهی این رباتها بسته شوند». با یک قاعدهی سراسری، همهی خزندههای هوش مصنوعی از سایت بیرون میمانند.
نُه ماه بعد: در گزارشها دو چیز به چشم میآید. اول، بار سرور واقعاً کم شده است. دوم، سهم ورودی از دستیارهای هوش مصنوعی، در حالی که در حوزهی آنها این سهم رشدی جدی داشت، تقریباً صفر مانده. هیچ عددی هم نداشتند که ثابت کند بستن، چه چیزی برایشان ساخته؛ چون اثر آموزش مدل، قابلاندازهگیری نیست.
تصمیم دوباره: سه کار انجام شد. اول، فهرست رباتها دستهبندی شد: آموزش بسته، جستجو و کاربر باز. دوم، قاعدهها از حالت سراسری به مسیرهای مشخص منتقل شدند؛ پنل کاربری و بخش دانلود فایل بسته ماند و مقالات باز شد. سوم، اجازهی دسترسی فقط در متن نماند و با لایهی CDN همراستا شد.
درس واقعی: بازکردن هم فوری نیست. هر خزنده برنامهی خزش خودش را دارد و ممکن است هفتهها طول بکشد تا رفتارش عوض شود. یعنی سیاست دسترسی، شبیه کلید برق نیست؛ شبیه شیر آب است که با تأخیر باز و بسته میشود. این را قبل از تصمیم بدانید، نه بعد از آن.
چهار پرسش که سیاست محتوایی شما را مشخص میکند
قبل از نوشتن هر خطی در فایل، این چهار پرسش را جواب بدهید. جوابها را بنویسید و نگه دارید؛ سال بعد به همان برمیگردید.
۱. منبع درآمد ما چیست؟ اگر ترافیک و تبلیغات است، رباتهایی که فقط میگیرند و پس نمیدهند هزینهی مستقیماند. اگر فروش محصول است، دیدهشدن در پاسخها غالباً ارزش بیشتری از پهنای باند مصرفی دارد.
۲. محتوای ما چقدر تکرارشدنی است؟ محتوای عمومی و آموزشی، مزیت رقابتیاش کمتر آسیب میبیند. محتوای اختصاصی، تحلیل دستاول و دادهی جمعآوریشدهی خودتان، دارایی است و باید با احتیاطتر باز شود.
۳. ظرفیت فنی ما چقدر است؟ اگر بار سرور گلوگاه است، مسیر درست بستن نیست؛ محدودکردن نرخ و تفکیک مسیرهاست. بستن کامل، یعنی هم ربات را از دست میدهید هم مسئله را حل نکردهاید.
۴. کدام کانال برای ما میآورد؟ نگاهی به آمار شش ماه گذشته بیندازید. اگر ورودی از دستیارها در حال رشد است، بستن یعنی چسبیدن به گذشته.
جمع این چهار جواب، شما را به یکی از سه سیاست میرساند: بستن همهی مسیرهای آموزش با بازگذاشتن جستجو، بستن کامل برای داراییهای حساس، یا بازگذاشتن همهچیز بهقصد سرمایهگذاری روی دیدهشدن. سیاست دوم برای اکثر سایتهای ایرانی بیدلیل است؛ سیاست سوم بدون آگاهی انتخاب میشود.
الگوی عملی: robots.txt که واقعاً کار میکند
فایل robots.txt بر پایهی یک استاندارد اینترنتی نوشته میشود، اما اجرای آن داوطلبانه است؛ قانون نیست، عرف است. چند قاعدهی فنی را بدانید تا سردرگم نشوید:
- هر دامنه و زیردامنه فایل خودش را دارد. مخصوصاً اگر سایت و وبلاگ دو زیردامنهاند، هر دو باید تنظیم شوند.
Disallow: /زیرUser-agent: *یعنی «همهی خزندهها بیرون»؛ این عمومیترین اشتباه پرهزینه است.- قاعدهی خاص بر قاعدهی سراسری اولویت دارد؛ یعنی میتوانید در متن قاعدهی کلی، یک مسیر را باز بگذارید.
- robots.txt جلوی ایندکسشدن را نمیگیرد. برای صفحههای حساس، راهحل ورود اجباری یا تگ noindex است، نه این فایل.
- تغییر فایل فوری اثر نمیکند. خزندهها نسخهی این فایل را مدتی نگه میدارند؛ برای گوگل این مدت تا حدود یک شبانهروز است.
الگوی پیشنهادی ما برای اکثر کسبوکارها، همان مسیر میانه است: آموزش بسته، جستجو باز.
User-agent: *
Disallow: /cart/
Disallow: /account/
Disallow: /wp-admin/
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: CCBot
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: Meta-ExternalAgent
Disallow: /
User-agent: Bytespider
Disallow: /
User-agent: OAI-SearchBot
Allow: /
User-agent: PerplexityBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
Sitemap: https://example.com/sitemap.xml
و اگر بخواهید لایهبندی دقیقتری داشته باشید — مثلاً مقالات باز و فروشگاه بسته:
User-agent: OAI-SearchBot
Allow: /blog/
Disallow: /shop/
Disallow: /api/
User-agent: PerplexityBot
Allow: /blog/
Disallow: /shop/
نکتهی مهم: این متن باید در لایهی CDN هم تأیید شود. اگر آنجا سیاست پیشفرض دیگری فعال است، فایل شما فقط یک سند آرزوست.
ابزارهایی که از robots.txt جلو زدهاند
robots.txt فقط «بله یا خیر» میگوید. واقعیت بازار بهسمت «با چه قیمتی؟» رفته است.
بعضی شرکتهای زیرساخت حالا بهجای بستن کامل، پاسخ پرداختلازم را برای خزندهها فعال میکنند و روی کل شبکهشان روزانه صدها میلیون تا میلیاردها پاسخ از این نوع ردوبدل میشود. مدل تازهتر از این هم در حال شکلگیری است: بهجای پرداخت در ازای هر بار خواندن، پرداخت در ازای هر بار استفاده؛ یعنی هر وقت محتوای شما مادهی خام یک پاسخ شد.
از آن طرف، استانداردهای تازهای در حال نوشتهشدن است تا اجازهی محتوا را بهجای یک کلید بله/خیر، به چند سیگنال تبدیل کند: استفاده در جستجو، استفاده در پاسخ، استفاده در آموزش. این پروندهها هنوز به بلوغ نرسیدهاند و بهتر است فعلاً اسمشان را در جلسات مدیریتی نیاورید؛ اما جهت حرکت روشن است.
یک نکتهی ظریف هم بماند: این ابزارها را با فایل معرفی محتوا اشتباه نگیرید. تفاوت این دو را در مقالهی «llms.txt چیست و آیا کسی آن را میخواند؟» جدا کردهایم؛ آن فایل میگوید چه چیزی را اول بخوان، اینجا بحث بر سر این است که اصلاً وارد شود یا نه.
برای اکثر کسبوکارهای ایرانی، این ابزارها سال اول لازم نیست. اول سیاست، بعد قرارداد، بعد ابزار.
- پیشنهاد ما به شما:
پنج خطای رایج که سیاست خوب را خراب میکند
- بستن گوگلبات بهقصد «نبودن در پاسخهای هوش مصنوعی». این کار شما را از جستجوی گوگل هم حذف میکند؛ قابهای هوش مصنوعی روی همان ایندکس سوارند.
- بستن GPTBot و انتظار داشتن خروج از چتجیپیتی. مسیر جستجو کلید جداگانهای دارد و شما اشتباه را بستهاید.
- فکرکردن به Google-Extended بهعنوان خزنده. این کلید برای آموزش است و هیچ اثری بر قابهای جستجو ندارد.
- ناهمخوانی robots.txt و لایهی CDN. نتیجهاش سیاستی است که در لاگ سرور خودش را تکذیب میکند.
- فراموشکردن زیردامنهها. سایتی که دامنهی اصلی را بسته و وبلاگش هنوز باز است، تصمیمش نصفه است.
هر کدام از این پنج مورد، در بخش فنی هزینهی کمی دارد و در نتیجهی کسبوکار هزینهی زیادی.
چکلیست اجرایی و مسیر پیشنهادی ما
ترتیب کار ساده است و در چند روز تمام میشود:
۱. فهرستبرداری کنید: با بررسی لاگ سرور، رباتهایی که واقعاً به سایت شما میآیند را فهرست کنید؛ نه آنهایی که در مقالهها اسمشان هست.
۲. دستهبندی کنید: آموزش، جستجو، کاربرمحور. همین سه برچسب کافی است.
۳. تصمیم را بنویسید: یک صفحه سند با تاریخ و دلیل. سیاست بدون دلیل نوشتهشده، سال بعد قابل دفاع نیست.
۴. اجرا و همراستاسازی: قواعد را با تیم فنی روی سایت پیاده کنید و مطمئن شوید لایهی CDN هم با همان تصمیم همقدم است. برای پایش، گزارش سرچ کنسول و لاگ سرور کافی است.
۵. سنجش ماهانه: درخواست هر ربات و ارجاع ورودی از دستیارها را هر ماه در یک برگه ثبت کنید. سه ماه بعد، دادهی خودتان جای بحث سلیقهای را میگیرد.
اگر میخواهید بدانید این جزئی کوچک از یک نقشهی بزرگتر چیست، مجموعهی مقالات سئو در تصویر کامل را نشان میدهد. برای پیادهسازی کامل اینجور کارها هم صفحهی خدمات سئو در راهها و مراحل را توضیح داده است.
جمعبندی
robots.txt امروز دو تصمیم را همزمان علنی میکند: چقدر محتوای شما مادهی خام باشد و چقدر دیده شوید. برای اکثر کسبوکارها مسیر میانه منطقیترین است: بلاک GPTBot بدون بستن مسیر دیدهشدن، یعنی آموزش بسته و جستجو و کاربرمحور باز — بهشرط اینکه لایهی CDN با همان تصمیم همقدم باشد و ماهانه سنجیده شود. قبل از هر تغییری، سیاست را روی کاغذ بنویسید تا سال بعد بدانید چرا اینطور تصمیم گرفته بودید.
قدم بعدی ساده است: امروز فهرست رباتهایی که به سایت شما میآیند را از لاگ سرور بیرون بکشید و در سه سبد دستهبندی کنید. همین یک کار، نصف تصمیم را میگیرد.
آمادهای قدم بعدی را برداری؟ برای مشاوره رایگان با کارشناسان تنا مدیا در اپلیکیشن بله (@tana_pr) پیام بده یا از صفحه تماس با ما اقدام کن.
پرسشهای متداول
نه. GPTBot هیچ نقشی در ایندکس یا رتبهبندی گوگل ندارد و بستنش فقط مسیر آموزشی یک شرکت دیگر را میبندد. اگر میخواهید سیاستی بگیرید که بر دیدهشدن شما در جستجو اثر بگذارد، به تنظیمات پیشنمایش و سرچ کنسول نگاه کنید.
نه. این کلید فقط بر استفادهی آموزشی از محتوای خزششده اثر دارد و خود گوگل گفته که بر حضور سایت در جستجو اثر نمیگذارد. بیرونماندن از قابهای هوش مصنوعی جستجو، تنظیم جداگانهای دارد و بهایش محدودشدن بخشی از حضور عمومی است.
چون کنترل دسترسی در چند لایه اعمال میشود و لایهی CDN یا فایروال ممکن است قاعدهی شما را نقض کند. در بررسیهای میدانی، این وضعیت در سهم قابلتوجهی از سایتها دیده شده است. اول مطمئن شوید هر دو لایه یک حرف میزنند.
بله، چون این دو مسیر ربات جداگانه دارند: GPTBot آموزش است و OAI-SearchBot جستجو. اولی را ببندید و دومی را باز بگذارید. دقت کنید که این کار فقط احتمال حضور شما را باز میکند؛ تضمینی برای استناد وجود ندارد و کیفیت محتوا هم شرط است.
تغییر فوری نیست. خزندهها نسخهی فایل شما را مدتی نگه میدارند و برای گوگل این مدت تا حدود یک شبانهروز است. در بقیهی موارد بسته به خزنده فاصلهها فرق میکند و میتواند هفتهها طول بکشد؛ پس برنامهی سنجش را با دید بلندمدت بچینید.
- پیشنهاد ما به شما: