Schema و AI: کارت شناسایی سایت، نه کلید جادویی
اسکیمای ساختاریافته اطلاعات صفحهی شما را به زبانی ترجمه میکند که ماشین بدون حدسزدن میفهمد: این یک مقاله است، نویسندهاش این شخص است، این یک محصول با این ویژگیهاست. اما یک واقعیت مهم وجود دارد که فروشندگان این خدمت کم به آن اشاره میکنند: گوگل صریحاً گفته برای دیدهشدن در پاسخهای هوش مصنوعی، هیچ اسکیمای ویژهای لازم نیست. بزرگترین آزمون میدانی هم که تا امروز انجام شده، روی نزدیک ۱٬۹۰۰ صفحه نشان داد افزودن اسکیما استنادهای هوش مصنوعی را بالا نمیبرد. پس چرا هنوز ارزش دارد؟ چون کارت شناسایی سایت شماست: نتایج ویژه در نتایج کلاسیک، روشنکردن هویت برند و نویسنده، و کمک به درستخواندهشدن صفحه.
نکات کلیدی
- اسکیما شرط ورود به پاسخهای هوش مصنوعی نیست؛ گوگل این را در مستنداتش صریح نوشته است.
- بزرگترین آزمون میدانی هیچ جهش استنادی نشان نداد؛ صفحههایی که اسکیما گرفتند، تفاوت معناداری با گروه کنترل نداشتند.
- همبستگی، دلیل نیست؛ صفحات دارای اسکیما بیشتر استناد میشوند، چون سایتهای مرتبتری هستند، نه بهخاطر خودِ کد.
- چتباتها اسکیمای پنهان را نمیخوانند؛ آنها متن دیدهشدنی صفحه را میخوانند.
- اسکیما برای نتایج ویژه، هویت برند و شفافیت ماشینی هنوز لازم است — فقط نه بهعنوان اهرم استناد.
اسکیما چیست؟ ترجمه، نه ترفند
اسکیما یا دادهی ساختاریافته، یک لایهی کد در پسزمینهی صفحه است که به ماشین میگوید محتوای شما دقیقاً چیست. قیمت این عدد است، این بخش پرسش و پاسخ است، نویسندهی مطلب این شخص است، نشانی این کسبوکار آنجاست.
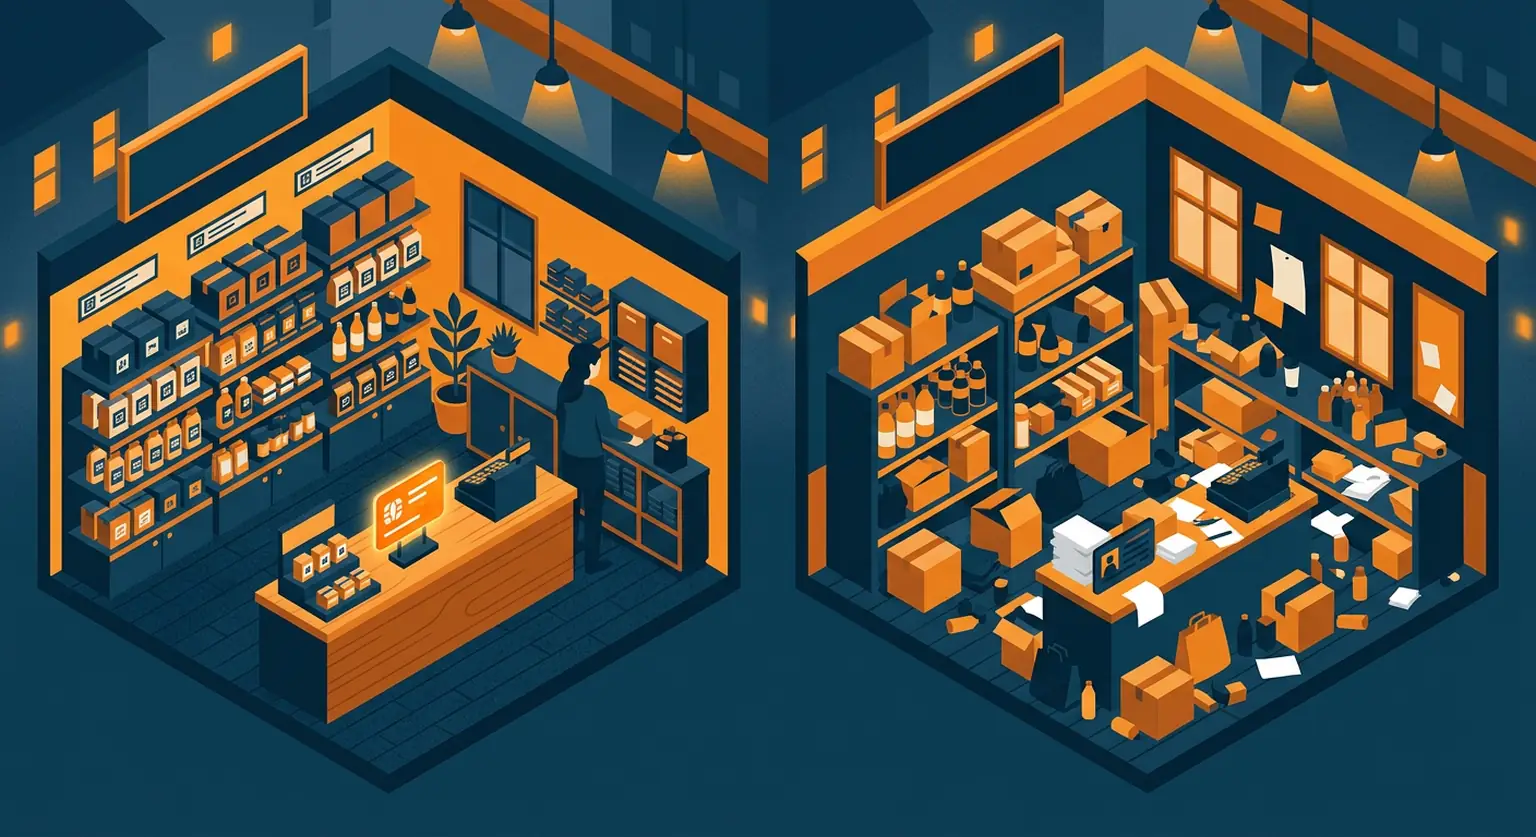
تمثیل ملموس: صفحهی شما یک مغازه است که همهچیز را بدون برچسب به ویترین چیده. اسکیما همان برچسبهاست. مغازه عوض نمیشود، اما کسی که وارد میشود، بدون حدسزدن میداند کدام قفسه چیست.
نکتهی مهمی که باید از ابتدا روشن باشد: اسکیما محتوای شما را جذاب نمیکند. اگر صفحهای بیارزش باشد، اسکیما آن را باارزش نمیکند. کارش فقط ترجمه است، نه persuasion.
خود گوگل هم این را در زبان فنیاش گفته است: اسکیمای درست، صفحه را برای نتایج ویژه واجد شرایط میکند؛ بیشتر از آن، وعدههای فروشندگان است. و یک هشدار صریح هم دارد: اگر اسکیما با محتوای دیدهشدنی صفحه همخوانی نداشته باشد، میتواند ریسک اقدام دستی بسازد. این را در بخش ۱۲ مفصل باز میکنیم.
گوگل دربارهی اسکیما و پاسخهای هوش مصنوعی چه گفته؟
اگر فقط یک بخش از این مقاله را بخواهید به خاطر بسپارید، این را به خاطر بسپارید. گوگل در مستنداتش دربارهی قابهای هوش مصنوعی، دو جملهی صریح دارد:
اول: برای ورود به این قابها نیازی به ساختن فایل ماشینی جدید یا کد ویژه ندارید.
دوم: هیچ اسکیمای ویژهای وجود ندارد که برای این قابها لازم باشد اضافه کنید.
در همان راهنمای رسمی، گوگل یک قدم جلوتر میرود و هشدار میدهد که زیاد درگیرکردن خود با دادهی ساختاریافته، مسیر اشتباهی است.
و اگر میخواهید این موضع را در کنار بحث فایلهای ویژهی هوش مصنوعی ببینید، در مقالهی «llms.txt چیست و آیا واقعاً کسی آن را میخواند؟» همهی زوایای همین داستان را باز کردهایم؛ همانجا هم گوگل جزو موارد بیاثر، دقیقاً همینها را نام برده است.
آزمونی که وعدههای بزرگ را تعدیل کرد
اینجا جایی است که مقالههای تبلیغاتی سکوت میکنند. یک شرکت تحلیلی معتبر، نزدیک به ۱٬۹۰۰ صفحهی واقعی را که در بازهی آبان ۱۴۰۴ تا اسفند ۱۴۰۴ اسکیمای جدید گرفته بودند، با حدود ۴٬۰۰۰ صفحهی کنترل مقایسه کرد. نتیجه:
| پلتفرم | تغییر استناد بعد از افزودن اسکیما | نتیجهی آماری |
|---|---|---|
| قابهای هوش مصنوعی گوگل | حدود ۴.۶٪ کاهش | کوچک اما معنادار |
| حالت هوش مصنوعی گوگل | حدود ۲.۴٪ افزایش | در حد نوسان تصادفی |
| چتجیپیتی | حدود ۲.۲٪ افزایش | در حد نوسان تصادفی |
جمعبندی خود پژوهشگران هم صریح بود: «اگر تنها دلیلی که اسکیما اضافه میکنید گرفتن استناد بیشتر در هوش مصنوعی است، دادههای ما از این تصمیم پشتیبانی نمیکند.»
اما یک شرط مهم: این آزمون روی صفحههایی انجام شد که پیش از آن هم استناد میگرفتند. یعنی هنوز معلوم نیست اسکیما برای صفحههای تازهوارد چه میکند — مثلاً آیا کمکشان میکند راحتتر خوانده و ایندکس شوند. این بخش هنوز بیجواب است و کسی که با قطعیت دربارهاش حرف بزند، از داده جلو زده است.
- پیشنهاد ما به شما:
پس چرا صفحات استنادشده اغلب اسکیما دارند؟
این سؤال، محل اصلی سوءتفاهم است. تحلیلها روی میلیونها آدرس نشان داده صفحههایی که در پاسخهای هوش مصنوعی استناد میشوند، تقریباً سه برابر بیشتر اسکیما دارند. همین عدد، در تبلیغات بهعنوان «اسکیما استناد میآورد» فروخته میشود.
اما دقت کنید. سه برابر بودن، فقط یعنی این دو چیز با هم همراهاند، نه اینکه یکی علت دیگری است.
تمثیل: فروشگاههایی که کارتخوان دارند، فروش بیشتری هم دارند. آیا کارتخوان فروش میسازد؟ نه؛ فروشگاههای مرتبتر و حرفهایتر هم کارتخوان دارند و هم فروش بیشتر.
واقعیت این است که سایتی که وقت میگذارد اسکیمایش را درست کند، همان سایتی است که محتوایش را هم جدی میگیرد، نویسندهاش را معرفی میکند و ساختار صفحهاش را مرتب نگه میدارد. اینها روی هم استناد میسازند.
خودِ پژوهشگران آزمایش بخش ۰۳ هم همین را گفتهاند: خیالشان راحت است که آن همبستگی سهبرابری، از محتوای بهتر میآید، نه از کد.
چتباتها اسکیما را میخوانند یا نه؟
این هم سؤالی است که جواب دقیقش بیشتر آدمها را غافلگیر میکند. آزمایشهایی که در آنها محتوای اسکیما پنهان شده و فقط متن دیدهشدنی قابلخواندن بوده، نشان داده چتباتها محتوای پنهان را برنمیدارند. آنها صفحه را مثل یک انسان میخوانند: متنی که روی صفحه دیده میشود.
یک تحلیل هم دربارهی صفحههای پرسشمتداول، نتیجهی معکوسی نشان داد: صفحههای دارای اسکیمای پرسشمتداول، میانگین استناد کمتری داشتند از صفحههای بدون آن. این عدد را نباید بهعنوان «اسکیما ضرر میزند» خواند؛ تفسیر درست این است که خودِ کد، مزیتی نساخته است.
جمعبندی این بخش: چیزی که خوانده میشود، محتوای دیدهشدنی شماست. اسکیما برای درستفهمیدن سیستمهایی است که مثل یک پارسر با صفحه برخورد میکنند — نه برای مدلهایی که صفحه را مثل متن میخوانند. و در این بین، موتور مایکروسافت جزو مواردی است که تأیید کرده اسکیما به مدلهایش در درک محتوا کمک میکند.
اگر استناد نمیآورد، چرا همچنان لازم است؟
چون چهار فایدهی واقعی دارد که هیچکدام هم دربارهی استناد در هوش مصنوعی نیست:
اول، نتایج ویژه در جستجوی کلاسیک. اسکیمای محصول، مقاله، بازبینی، مسیر راهنما و کسبوکار محلی، همچنان در نتایج نمایشهای ویژه و پرکلیک میسازد. گوگل در مثال خودش، نرخ کلیک صفحههای دارای نتایج ویژه را بهمراتب بالاتر از صفحههای بدون آن گزارش کرده است. این ترافیک واقعی است.
دوم، دادهی زندهی فروش. برای فروشگاههای اینترنتی، قیمت، موجودی و شیوهی ارسال از همین لایه خوانده میشود. این یکی نه فقط مفید، بلکه لازم است.
سوم، روشنکردن هویت برند و نویسنده. همان چیزی که در مقالهی «E-E-A-T: تجربه و تخصص؛ اثر انگشتی که جعل نمیشود» بهعنوان زنجیرهی هویت معرفی کردیم، بخش فنیاش همینجاست.
چهارم، کاهش ابهام برای همهی ماشینها. وقتی روشن است این صفحه دربارهی چیست، کدام بخشش مقاله است و کدام بخشش پرسش و پاسخ، سیستمها راحتتر و مطمئنتر تصمیم میگیرند.
یک جملهی کوتاه از یکی از مدیران گوگل، تصویر را خوب جمع میکند: پاسخ اینکه «اسکیما به مدلها کمک میکند؟» چیزی شبیه «بله، نه، و بستگی دارد» است.
- پیشنهاد ما به شما:
برای سایت فارسی، کدام انواع اسکیما اولویت دارند؟
اگر تازه شروع میکنید، همهچیز را با هم پیاده نکنید. این ترتیب اولویت را پیشنهاد میکنیم:
| اولویت | نوع اسکیما | چه چیزی به دست میآورید |
|---|---|---|
| ۱ | برند و سازمان | کارت شناسایی اصلی سایت؛ پایهی همهچیز |
| ۲ | مقاله | نمایش بهتر و روشنکردن نویسنده و تاریخ |
| ۳ | مسیر راهنما | نمایش مسیر در نتایج و فهم بهتر ساختار سایت |
| ۴ | شخص (برای نویسنده) | اتصال نام نویسنده به هویت قابلراستیآزمایی |
| ۵ | محصول و بازبینی | فقط برای فروشگاهها؛ نمایش قیمت و امتیاز |
| ۶ | کسبوکار محلی | اگر مشتری محلی دارید؛ نشانی، ساعت کاری، تلفن |
| ۷ | پرسشهای متداول | فقط اگر محتوای پرسشوپاسخ واقعی دارید |
سه نکته دربارهی این جدول:
- سه مورد اول برای هر سایتی لازم است. بقیه بسته به نوع کسبوکار.
- فقط آن چیزی را علامت بزنید که در صفحه هست. برچسب روی قفسهی خالی، بدتر از بیبرچسبی است.
- قالب پیشنهادی، نسخهی جیسون است. سادهتر برای نگهداری و همان چیزی که مستندات گوگل توصیه میکند.
کد نمونه: از برند تا مقاله
لازم نیست برنامهنویس باشید تا بفهمید این لایه چه شکلی است. نمونهی زیر یک اسکیمای برند است که مهمترین بخشش، همان بخش اتصالهاست:
{
"@context": "https://schema.org",
"@type": "Organization",
"name": "نام کسبوکار",
"url": "https://example.com",
"logo": "https://example.com/logo.png",
"description": "توضیح یکخطی کسبوکار",
"sameAs": [
"https://www.linkedin.com/company/…",
"https://www.instagram.com/…",
"https://en.wikipedia.org/wiki/…"
]
}و نمونهی اسکیمای مقاله با نویسنده:
{
"@context": "https://schema.org",
"@type": "Article",
"headline": "عنوان مقاله",
"author": {
"@type": "Person",
"name": "نام و نام خانوادگی نویسنده",
"sameAs": "https://example.com/author/…"
},
"datePublished": "2026-01-01",
"dateModified": "2026-09-15",
"publisher": { "@type": "Organization", "name": "نام کسبوکار" }
}دو چیزی که در این نمونهها مهمتر از بقیه است: بخش اتصالها که هویت شما را به پروفایلهای بیرونی وصل میکند، و تاریخ بهروزرسانی که نشان میدهد محتوا زنده است.
و یک هشدار: همان هویتهایی که اینجا اعلام میکنید، باید در صفحههای واقعی سایت هم وجود داشته باشند. اسکیما سند تعهد است، نه جایگزین واقعیت.
کارت شناسایی برند و نویسنده
اگر بخواهم از کل این مقاله یک توصیهی عملی بکشم بیرون، این است: قبل از فکرکردن به استناد، هویتتان را درست کنید.
- برند شما باید یک موجودیت روشن باشد. یک نام، یک حوزه، یک توضیح ثابت. اگر در سایت «تنا»، در اینستاگرام شکل دیگری و در امضای ایمیل سومی نوشته شده، سیگنال را تکهتکه کردهاید.
- نویسنده باید قابلراستیآزمایی باشد. نام کامل، صفحهی نویسنده، اتصال به پروفایل بیرونی.
- صفحهی دربارهی ما باید واقعی باشد. نه سه خط تعارف؛ اینکه کی هستید و چه میکنید.
و یک جمله که باید بالای میز هر تیم محتوایی بچسبد: کد میتواند یک مدرک را توصیف کند، اما نمیتواند بسازدش. اگر نویسندهی واقعی ندارید، بهترین اسکیما هم این را جبران نمیکند.
- پیشنهاد ما به شما:
یک نمونهی ایرانی: چهار ماه کار روی اسکیما
این سناریو از پروژههای واقعی است؛ نامها را تغییر دادهام.
وضعیت شروع: یک فروشگاه اینترنتی متوسط. تیمشان جایی خوانده بود که اسکیما کلید ورود به پاسخهای هوش مصنوعی است. چهار ماه وقت برنامهنویس را گرفتند تا برای همهی صفحات، هر نوع اسکیمایی که پیدا کردند پیاده کنند — از جمله پرسشهای متداول برای تمام مقالات.
نتیجهی صادقانه: استناد در پاسخهای هوش مصنوعی تقریباً تغییری نکرد. کاری که عوض شد، چیز دیگری بود: اگر اسکیما درست اضافه نشده بود، هیچ اتفاقی هم نمیافتاد؛ اما وقت تیم صرف چیزی شده بود که بازده مستقیمی نداشت.
بازچینی تصمیم: سه کار انجام شد.
1. اسکیما به چهار نوع محدود شد: برند، مقاله، مسیر راهنما، و محصول. بقیه کنار رفت.
2. برای محصولها، قیمت و موجودی مرتب شد؛ همین لایه باعث شد نمایش محصولات در نتایج بهتر شود.
3. انرژی آزادشده رفت روی کاری که مقالهی «تولید محتوا با هوش مصنوعی؛ مرز کمک و تخلف کجاست؟» دربارهاش حرف میزند: بازچینی محتوای صفحههای اصلی و اضافهکردن دادهی واقعی به آنها.
درسی که ماند: اسکیما کار درست است، اما اگر بهعنوان «اهرم استناد» فروخته شود، وقت و بودجه را از کارهای مؤثرتر میدزدد.
اشتباهات و ریسکها
- اسکیمای بیهمخوان با صفحه. اگر در کد، سؤالی باشد که در صفحه نیست، این ناهمخوانی است و ریسک اقدام دستی دارد.
- برچسب زدن به محتوای جعلی. اسکیمای بازبینی برای محصولی که کسی امتحانش نکرده، و اسکیمای امتیاز بدون بازبینی واقعی.
- پیادهکردن کد برای «هوش مصنوعی». هیچ اسکیمای ویژهای برای آن وجود ندارد؛ این کار فقط وقت میبرد.
- رهاکردن کد قدیمی. کدی که به محتوای حذفشده اشاره میکند، بدتر از نبودنش است.
- اعتماد به ابزارهای اعتبارسنجی منسوخ. بخشی از بررسیهای مربوط به پرسشهای متداول در ابزارهای گوگل حذف شده؛ برای اعتبارسنجی عمومی از ابزار خودِ مجموعهی اسکیما استفاده کنید.
- افتکردن در دام وعدهها. هر کس گفت «با این اسکیما در چتجیپیتی دیده میشوید»، داری چیزی میفروشد. دادهای که این وعده را پشتیبانی کند وجود ندارد.
چکلیست ۳۰ دقیقهای و روش سنجش
چکلیست سریع برای همین امروز:
1. صفحهی اصلی سایت، اسکیمای برند دارد؟
2. بخش اتصالها به پروفایلهای بیرونی کامل است؟
3. مقالهها اسکیمای مقاله با نام نویسندهی واقعی دارند؟
4. تاریخ بهروزرسانی در کد میآید یا فقط تاریخ انتشار؟
5. کدهای پرسشمتداول با محتوای دیدهشدنی صفحه جورند؟
6. اگر فروشگاه دارید، قیمت و موجودی از کد خوانده میشود؟
7. هیچ کدی به محتوای حذفشده اشاره نمیکند؟
و روش سنجش: اسکیما را با معیارهای خودش بسنجید، نه با استناد.
| چه چیزی را بسنجید | چطور | چرا |
|---|---|---|
| نمایشهای ویژه در ابزار وبمستر | گزارش نتایج ویژه | مزیت واقعی اسکیما همینجاست |
| نرخ کلیک صفحههای دارای نتیجهی ویژه | مقایسه با صفحههای بدون آن | اثر اقتصادی مستقیم |
| دقت اطلاعات محصول | بررسی دورهای کد با صفحه | جلوگیری از ناهمخوانی |
| سلامت کد | اعتبارسنجی دورهای | نگهداری، نه استناد |
اگر میخواهید پیش از صرف وقت، تصویر کامل این بحث را ببینید، مقالهی «AI Overviews چیست؟ چرا کلیکها کم شد و چطور زنده بمانیم» را بخوانید؛ همانجا نشان دادهایم چرا رتبهی کلاسیک همچنان بلیت ورود است.
جمعبندی
اسکیما کلید جادویی نیست؛ کارت شناسایی سایت شماست. گوگل گفته برای پاسخهای هوش مصنوعی به آن نیازی نیست و آزمونهای میدانی هم نشان داده استناد نمیسازد. اما برای نتایج ویژه، شفافیت هویت و درستخواندهشدن صفحه، هنوز کار میکند — و ترککردنش، از دست دادن همان مزیتهاست.
مهمترین برداشت: اسکیما را با معیار خودش بسنجید، نه با معیاری که فروشندگان به شما تحمیل میکنند.
قدم بعدی: چکلیست هفتبندی بخش ۱۳ را روی سایتتان اجرا کنید. نیمساعت وقت میبرد و مشخص میکند کدام بخش هویتتان برای ماشین مبهم مانده است.
اگر میخواهید لایهی فنی سایتتان را یکجا و اصولی مرتب کنید، «سئو تکنیکال: مترجم اختصاصی بین وبسایت و رباتهای گوگل» نقطهی شروع درستی است و دانشنامهی سئو تنا مدیا همهی این مسیر را کنار هم چیده است. اگر ترجیح میدهید پیادهسازی و بازبینی اسکیما را تیم ما انجام دهد، خدمات سئو تنا مدیا از همینجا شروع میشود.
آمادهای قدم بعدی را برداری؟ برای مشاوره رایگان با کارشناسان تنا مدیا در اپلیکیشن بله (@tana_pr) پیام بده یا از صفحه تماس با ما اقدام کن.
پرسشهای متداول
نه. گوگل صریحاً گفته هیچ اسکیمای ویژهای برای ورود به قابهای هوش مصنوعی لازم نیست و بزرگترین آزمون میدانی هم نشان داد افزودن اسکیما، استنادها را بالا نمیبرد. برای دیدهشدن، محتوای پاسخمحور و رتبهی مناسب مؤثرترند.
نه، اسکیما فاکتور رتبهبندی نیست. کارش واجدشرایطکردن صفحه برای نتایج ویژه است، نه جابهجاکردن جایگاهش. هر بهبود رتبهای که همراه با افزودن اسکیما دیده شود، احتمالاً از تغییرهای محتوایی میآید که همزمان انجام شده.
نه، حداقل بهصورت یکجا. نمایش ویژهاش بازنشسته شده، اما خودِ اسکیما معتبر است و حذفش ضروری نیست. فقط کدهایی را اصلاح کنید که با محتوای فعلی صفحه همخوان نیستند.
در خواندن مستقیم صفحه، نه؛ آزمایشها نشان میدهد متن دیدهشدنی خوانده میشود، نه کد پنهان. بعضی موتورهای مایکروسافت تأیید کردهاند که اسکیما به مدلهایشان کمک میکند، و سیستمهای مبتنی بر فهرست جستجو ممکن است از آن بهره ببرند.
برای نتایج ویژه در جستجوی کلاسیک، دادهی زندهی فروشگاه، و روشنکردن هویت برند و نویسنده. اینها مزیتهای واقعی و قابلاندازهگیریاند؛ فقط با استناد در هوش مصنوعی فرق دارند.
- پیشنهاد ما به شما: